AI 的自我改进:自审查、自闭环与自演进
收录于 AI 浏览量
这个系列写到第八篇,主角都在回答同一个问题:模型怎么干活——底层架构决定它能不能跑,推理逻辑决定它怎么想,Agent 工作原理决定它怎么行动,Skills 和 MCP 决定它怎么长本事。但这几篇都停留在单个任务内部。这篇把时间维度加上去:AI 怎么在干完活之后变得更强?“自审查、自闭环、自演进”这三个词你大概都见过,但经常被混用——实际上是三个不同层次的闭环。
收录于 AI 浏览量
这个系列写到第八篇,主角都在回答同一个问题:模型怎么干活——底层架构决定它能不能跑,推理逻辑决定它怎么想,Agent 工作原理决定它怎么行动,Skills 和 MCP 决定它怎么长本事。但这几篇都停留在单个任务内部。这篇把时间维度加上去:AI 怎么在干完活之后变得更强?“自审查、自闭环、自演进”这三个词你大概都见过,但经常被混用——实际上是三个不同层次的闭环。
收录于 AI 浏览量
这个系列已经写了四篇:OpenCode 教程、Agent 推理逻辑、Agent 工作原理、AI 底层架构。有读者说该有个起点——对,这篇补上:大语言模型本身。不讲工程栈,讲一个使用者最该懂的概念:它是什么、能力从哪来、边界在哪、怎么把它用好。看完这篇再读系列其他篇,会顺很多。
收录于 AI 浏览量
大语言模型基础讲了模型“是什么”,AI 底层架构讲了“跑在什么上面”,中间还缺一块:模型本体长什么样。这篇把 Transformer 拆开——从整体结构到每个组件的职责,看完你就能把“注意力、多头、前馈网络、残差、归一化”这些术语各归各位。
收录于 AI 浏览量
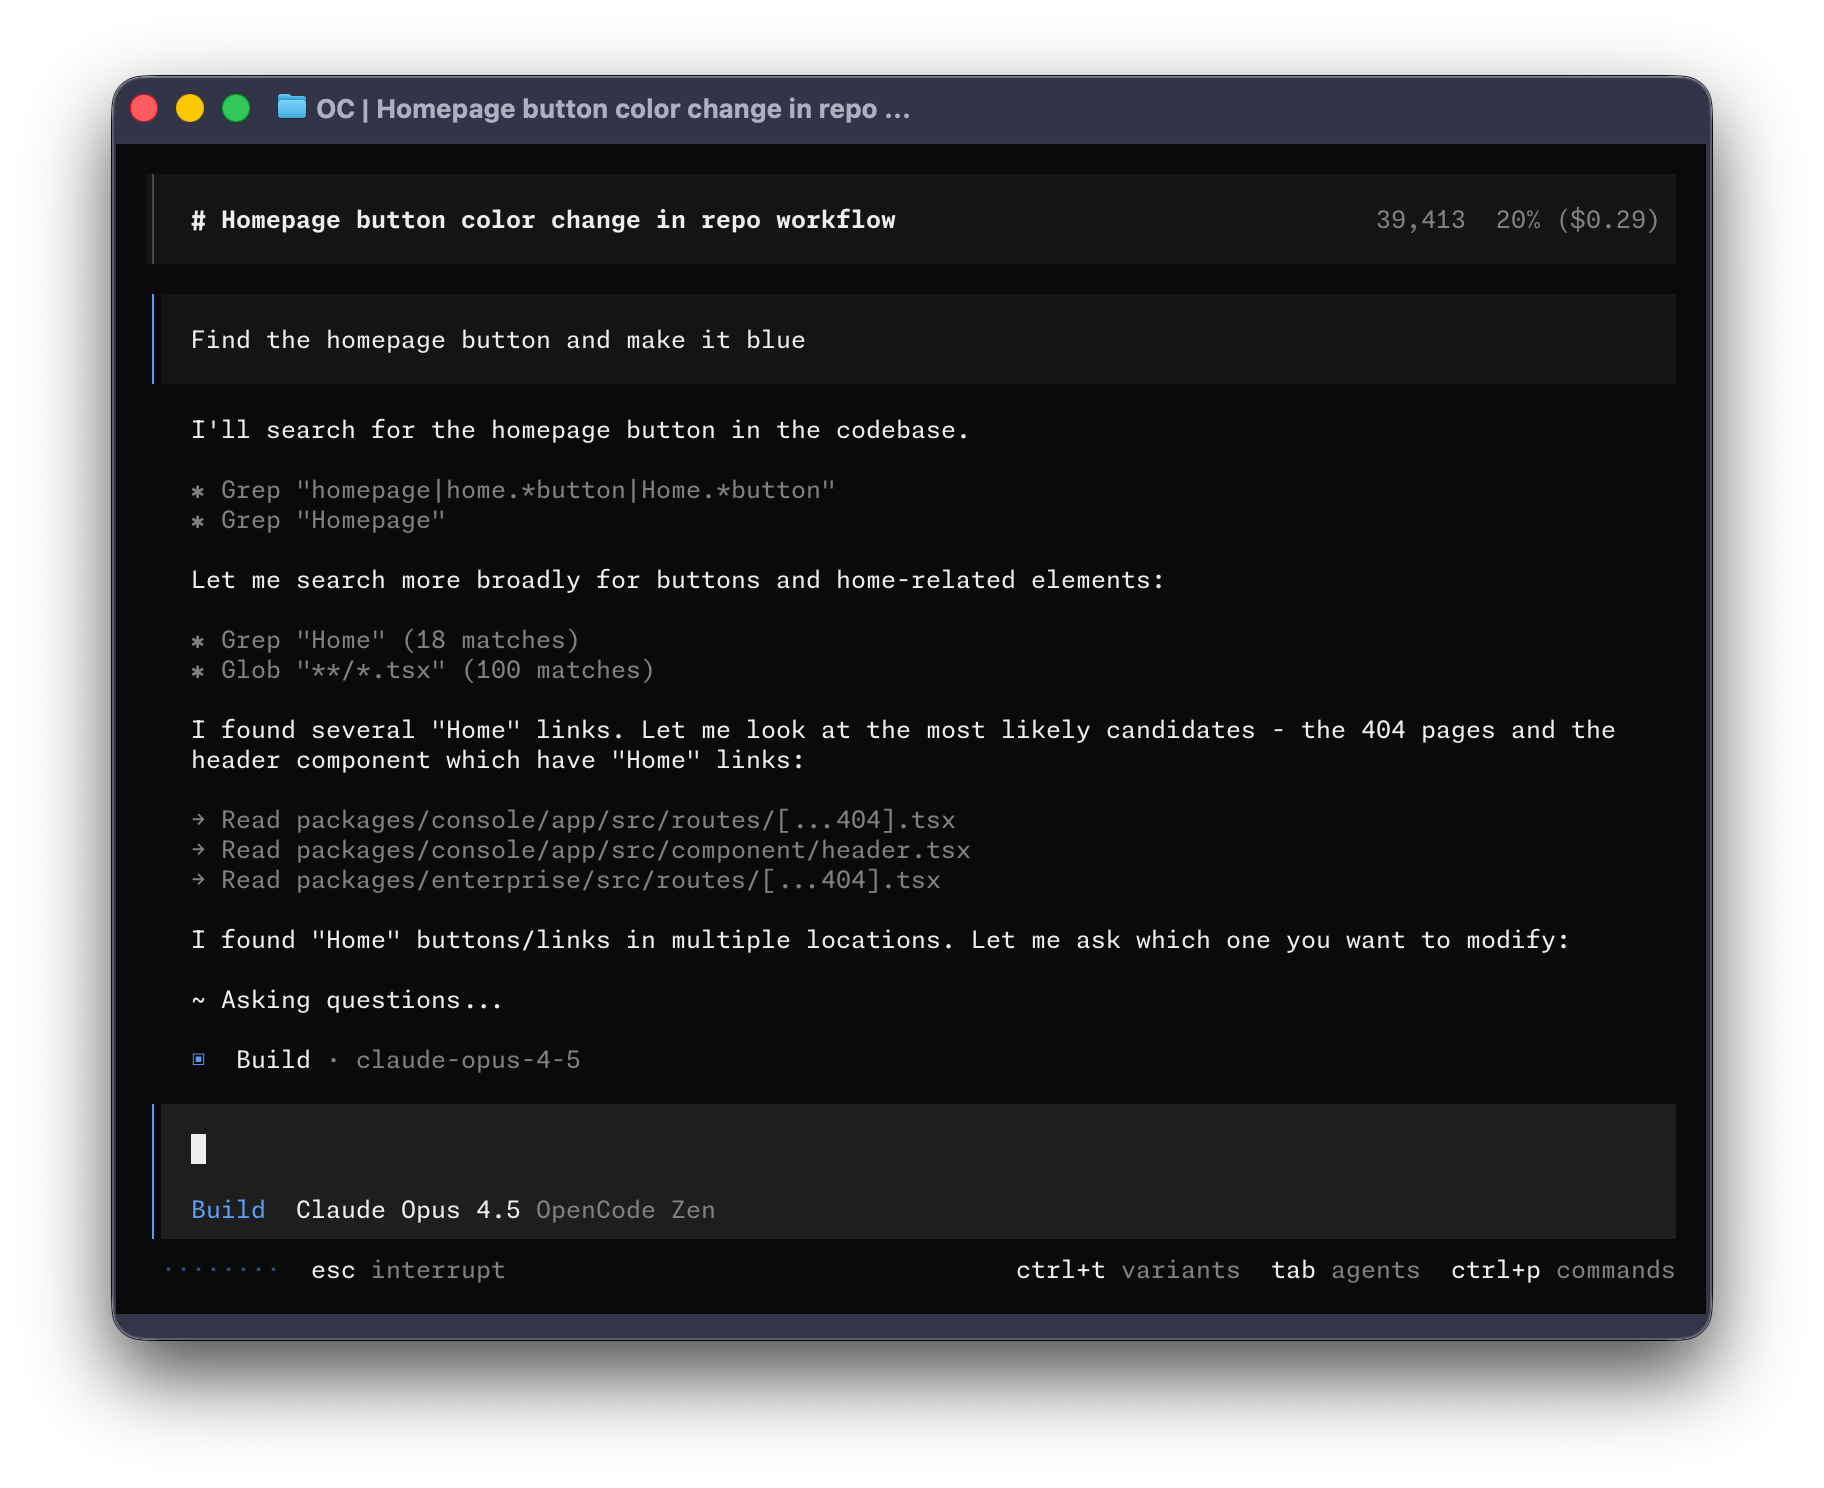
AI 编码助手这两年层出不穷,但大多绑死在某一家厂商的客户端里。OpenCode 是一个开源的 AI 编码代理(AI coding agent):它把“能读写你代码库、能执行命令、能自己多步干活的 AI 助手”做成了一款终端优先的工具,同时提供桌面 App 和 Web 界面。模型随便换——Anthropic、OpenAI、Google 或任何兼容供应商都行,数据和工作流都留在你自己的机器上。
收录于 AI 浏览量
OpenCode 入门教程里我们用过它的自定义命令和子代理,这篇补上第三种扩展机制:Skills(技能)。它解决的是所有 Agent 都要面对的一个问题——上下文是有限的,而“怎么干活”的知识越来越多。